Por Suso Merino · CEO
Como funciona por dentro un motor de anonimización de documentos
28 de agosto de 2026
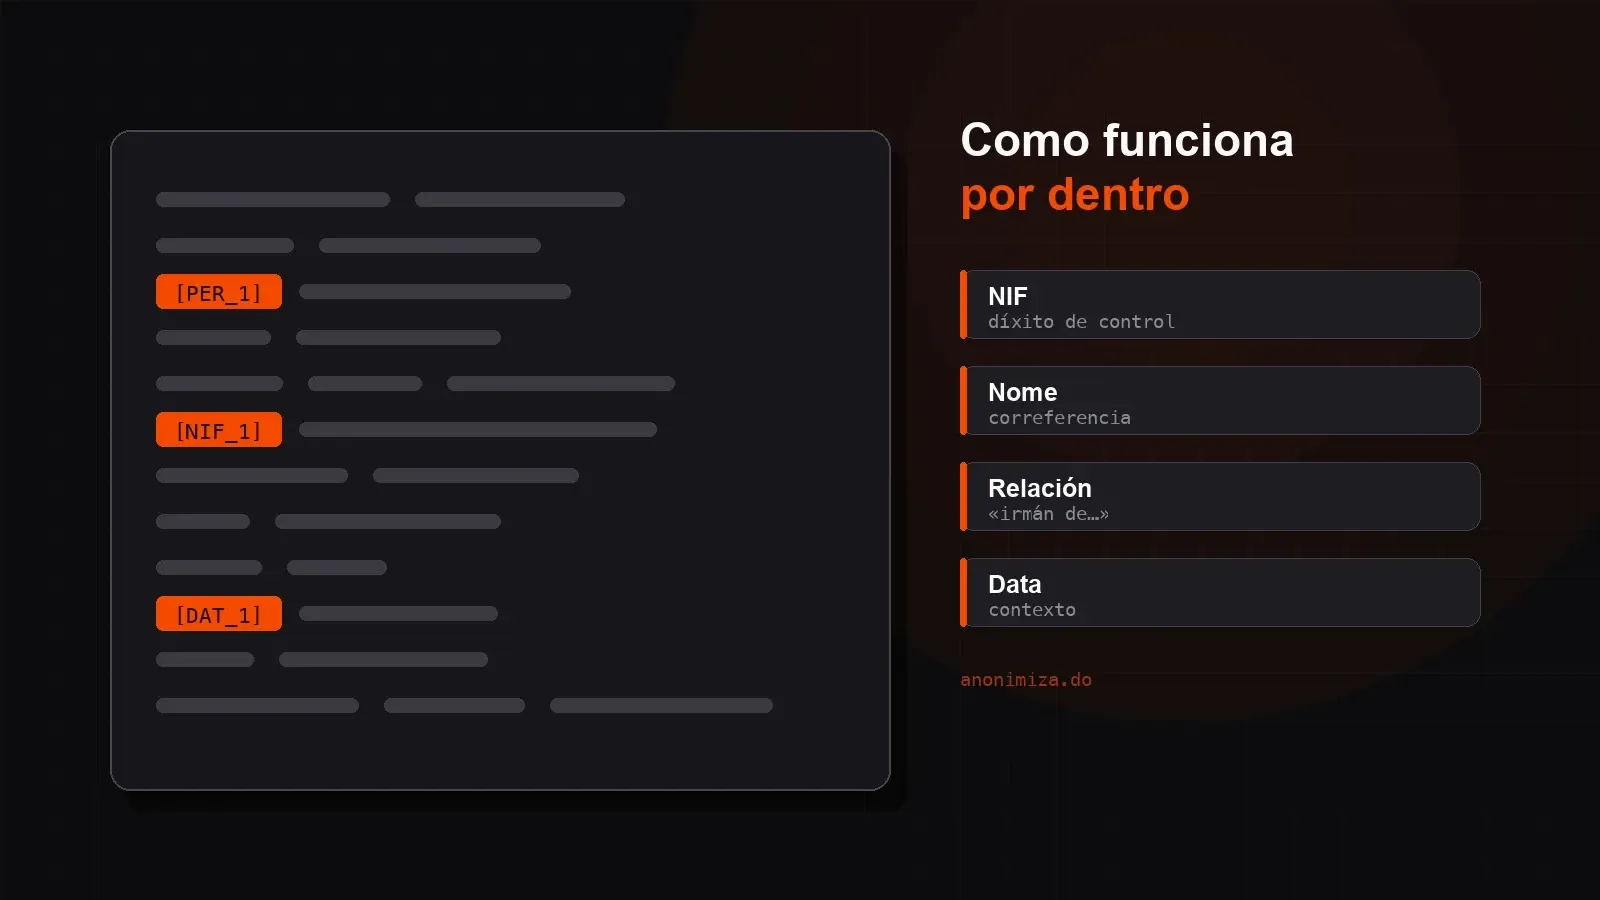
Case todo o mundo imaxina a anonimización como un buscar e substituír un pouco máis listo: localizas o DNI, ríscalo e xa está. Quen intentou facelo a escala sabe que non. Un expediente administrativo real trae nomes escritos de catro maneiras distintas, números de nove díxitos que ás veces son un teléfono e ás veces non, referencias a decretos que non hai que tocar e persoas que aparecen identificadas sen que o seu nome figure en ningures.
Este artigo abre a caixa e conta que ocorre entre que subes un documento e recibes o resultado. Se o que buscas é a ficha do produto —que tipoloxías, que formatos, que garantías—, está nas especificacións técnicas.
Por que ningunha técnica serve por si soa
Hai dúas familias de ferramentas para localizar datos persoais nun texto, e cada unha falla xusto onde a outra acerta.
As regras deterministas —expresións regulares, validadores de formato— son cirúrxicas co que ten estrutura. Un NIF, un IBAN ou un correo electrónico descríbense con precisión e atópanse sen marxe de dúbida. Pero non teñen nin idea de lingua: para unha expresión regular, «Ávila» e «Ana Ávila» son igual de opacos.
Os modelos de linguaxe fan exactamente o contrario. Recoñecen que «a Sra. Fernández Iglesias» é unha persoa e que «Talarrubias» é un municipio, porque viron millóns de frases parecidas. O que non saben facer é unha división entre 23 para comprobar se a letra dun DNI cadra.
A conclusión práctica é que un motor serio non escolle: encadea varias pasadas especializadas, cada unha achegando candidatos coa súa propia puntuación de confianza, e deixa a decisión final para o último paso.
As capas, unha a unha
| Capa | Que resolve |
|---|---|
| Extracción e normalización | Saca o texto do documento ofimático, das celas ou da capa de texto do PDF, e garda a posición exacta de cada fragmento. Sen esa posición, a substitución despraza o resto do documento e rompe a maquetación |
| Recoñecedores deterministas | Localizan os identificadores de estrutura coñecida e comproban que son matematicamente válidos antes de dalos por bos |
| Recoñecemento de entidades | Un modelo adestrado en español localiza persoas, organizacións e lugares en texto libre; un segundo modelo admite tipoloxías novas descritas en linguaxe natural |
| Correferencia | Agrupa todas as mencións que se refiren á mesma persoa |
| Relacións e cuasi-identificadores | Detecta a quen queda identificado polo seu vínculo, o seu cargo ou unha combinación de atributos |
| Control de calidade | Mide o acerto de forma desagregada e corrixe as desviacións coñecidas dos modelos |
| Decisión | Resolve solapamentos, aplica limiares, modelo, lista branca e lista negra, e rexistra a orixe de cada substitución |
Cada capa apóiase na anterior. Se a extracción perde a posición do texto, a substitución aplícase no sitio equivocado por moi ben que funcionase o modelo de entidades.
Validar antes de riscar
Atopar unha cadea coa forma dun DNI é doado. Comprobar que é un DNI require facer a conta. É a diferenza entre riscar un número de expediente porque se lle parece e deixalo onde está.
| Identificador | Comprobación |
|---|---|
| NIF de persoa física | Letra de control polo resto da división entre 23 |
| NIE | A inicial X, Y ou Z substitúese polo seu valor numérico antes de calcular a letra |
| NIF de persoa xurídica | Díxito ou letra de control segundo o tipo de entidade |
| Número da Seguridade Social | Díxitos de control por módulo 97 |
| IBAN | Norma ISO 13616, comprobación por módulo 97 |
| Matrícula de vehículo | Formato actual e formatos provinciais históricos |
| Código seguro de verificación | Patrón configurable, porque cada organismo emisor usa o seu |
| Correo, IP, URL | Validación sintáctica |
Hai un caso que merece parágrafo á parte, e é o que máis documentos administrativos arruinou: as referencias normativas. «Decreto 45/2019, de 3 de abril» é, para un detector inxenuo, unha data acompañada de dous números. Se o risca, o resultado é unha resolución ilexible na que desapareceu precisamente a norma que a xustifica. Por iso as citas a leis, decretos e circulares recoñécense non para anonimizalas, senón para protexelas da anonimización.
Sobre esa base actúa o realce por contexto. Un número de nove díxitos illado é ambiguo; o mesmo número precedido de «teléfono de contacto» deixa de selo. As palabras da contorna inmediata —DNI, conta, domicilio, expediente— soben ou baixan a confianza do candidato.
Queres ver isto sobre os teus propios documentos?
Sobe un expediente real e mira que detecta, con que confianza e por que. Tres documentos gratis, sen tarxeta.
Probar gratisUnha decisión por persoa
Nun expediente longo, a mesma persoa aparece como «Doña María Luisa Fernández Iglesias» no encabezamento, como «a solicitante» nos antecedentes, como «a interesada» nos fundamentos e como «a Sra. Fernández» no fallo. Un sistema que trate cada mención por separado obrigarate a tomar corenta decisións sobre a mesma persoa, e abondará con que se che escape unha.
A correferencia constrúe a lista de persoas do documento e colga de cada unha todas as súas aparicións. Decides unha vez e a decisión propágase. É tamén o que fai que a tokenización sexa estable: se todas as mencións de alguén se agrupan, todas poden recibir a mesma etiqueta, e [PER_1] segue a ser a mesma persoa corenta páxinas máis adiante.
A quen se identifica sen ser nomeado
«O irmán da solicitante» é un dato persoal. «A alcaldesa dun municipio de 3.000 habitantes», tamén. Ningún dos dous contén un nome, e os dous permiten chegar a unha persoa concreta con dous clics.
O Comité Europeo de Protección de Datos chama singularización a que un rexistro poida illarse dentro dun conxunto, e considéraa un dos tres riscos que hai que descartar para poder afirmar que un dato é anónimo. Os outros dous son a vinculabilidade e a inferencia, e desenvolvémolos na guía sobre anonimización e pseudonimización.
Detectar eses vínculos non abonda: hai que decidir que facer con eles, e a resposta depende do destino do documento. Xeneralizar o vínculo («irmá de [PER_2]») adoita ser suficiente para publicar unha resolución nun portal de transparencia. Neutralizar o cargo converte «alcalde de Santa Cruz de la Palma» nunha categoría xenérica. E para ceder un conxunto de expedientes con fins estatísticos, suprimir o sintagma enteiro é máis seguro ca calquera maquillaxe.
Os dous erros non custan o mesmo
Aquí hai unha decisión de deseño que convén entender, porque explica o comportamento do sistema.
Un falso positivo —riscar algo que non era un dato persoal— custa lexibilidade e arránxase en dous clics na pantalla de revisión. Un falso negativo —deixar un dato persoal á vista— é unha comunicación non autorizada de datos persoais, co que iso implica ante a AEPD.
Como os dous erros non son simétricos, a calibración tampouco o é: ante a dúbida, márcase. A precisión recupérase despois, na revisión humana, que é rápida porque consiste en descartar o que sobra e non en buscar o que falta. Se o teu caso pide outro equilibrio, os limiares de confianza axústanse por tipoloxía.
Por que se substituíu cada dato
Unha anonimización que non podes explicar é unha anonimización que non podes defender. Por cada substitución aplicada convén poder responder a catro preguntas: que capa a orixinou, que tipoloxía se lle asignou, con que confianza exacta —o número, non un «alta» ou «media»— e que disparou a detección.
Serve para tres cousas moi prácticas: entender un resultado que te sorprendeu, axustar a configuración con criterio en lugar de por proba e erro, e documentar ante un terceiro como se tomou unha decisión automática sobre un documento. O terceiro deixa de ser opcional en canto o documento vai a un expediente público.
O nesgo tamén é un problema de protección
Os modelos de recoñecemento de entidades adéstranse con texto público, e ese texto non está equilibrado. Está medido e documentado que os sistemas de recoñecemento de nomes acertan menos con nomes femininos ca con masculinos, e menos con apelidos de orixe non hispánica ca con casteláns.
En case calquera outra aplicación iso sería un problema de calidade. En anonimización é un problema de dereitos: significa que unhas persoas quedarían mellor protexidas ca outras polo feito de como se chaman. As medidas razoables son catro, e ningunha é exótica:
- Medir por separado, non en agregado. Unha media alta pode agochar un subgrupo mal cuberto.
- Cubrir a flexión: irmán e irmá, alcalde e alcaldesa, concelleiro e concelleira, don e doña.
- Axustar o limiar do subgrupo que se recoñece con menos confianza, en lugar de aplicar un único limiar que o deixaría fóra.
- Ampliar os recursos léxicos cara a onde sinale a medición.
Nada disto elimina o nesgo; faino medible e redúceo. Que a revisión humana siga a formar parte do procedemento recomendado non é unha cláusula de estilo: é a consecuencia lóxica de admitir que ningún modelo acerta sempre.
Cando o documento é un escaneado
Se o ficheiro non ten capa de texto —un escaneado, unha fotografía, un fax dixitalizado—, o recoñecemento óptico deixa de ser un accesorio e pasa a determinar a calidade de todo o demais. Un bo proceso fai catro cousas: preprocesa a imaxe adaptándose a ela (endereitado, ruído, perspectiva, binarización), transcribe con tolerancia a selos superpostos e tipografías de máquina de escribir, analiza a estrutura da páxina para non mesturar dúas columnas contiguas, e realimenta: cando aparece un candidato de baixa confianza sobre texto recoñecido opticamente —un NIF cuxa letra non cadra, unha data imposible—, esa rexión vólvese examinar con outros parámetros.
Hai un detalle que en documentación de arquivo marca a diferenza: o recoñecemento óptico perde os tiles con frecuencia, e un texto onde «Fernández» aparece como «Fernandez» degrada a detección de nomes propios. Por iso a comparación ten que ser insensible á acentuación desde a capa de normalización.
E unha advertencia sobre o resultado: nunha imaxe, a substitución debe aplicarse sobre os píxeles. Un rectángulo negro de anotación PDF ou unha capa superposta retíranse con calquera visor, e o dato segue aí debaixo.
Follas de cálculo: manda a columna
Nunha folla de cálculo ou nun envorcado de base de datos, analizar cada cela pola súa conta é un erro de bulto. O correcto é inferir a tipoloxía da columna completa, a partir do conxunto dos seus valores e do encabezado, e aplicala a todas as súas celas, incluídos os valores atípicos: a que ten un espazo de máis, a que leva a letra en minúscula, a que quedou baleira.
E en datos estruturados hai un risco que non se ve mirando as columnas dunha en unha. Código postal, ano de nacemento, sexo e categoría profesional son catro campos inocentes que, combinados, poden deixar unha única persoa no seu grupo. Verificar a k-anonimidade consiste en fixar un valor de k e comprobar que combinacións quedan por debaixo dese limiar. A AEPD recólleo na súa nota técnica sobre k-anonimidade e a norma ISO/IEC 20889:2018 sitúao entre as técnicas de desidentificación recoñecidas. É a comprobación pertinente antes dunha cesión estatística ou de publicar un conxunto de datos abertos, onde non abonda con ter borrada a columna do nome.
Preguntas frecuentes
Por que non abonda con expresións regulares para anonimizar documentos?
Porque só atopan o que ten estrutura fixa. Un NIF ou un IBAN si; un nome propio, un enderezo escrito en prosa ou «o irmán da solicitante», non. E sen validación do díxito de control, unha expresión regular risca calquera número que se pareza a un DNI, incluídos os de expediente.
Que é a correferencia e por que importa ao anonimizar?
É agrupar todas as formas en que un documento nomea a mesma persoa: nome completo, apelido con tratamento e designacións polo seu papel, como «a interesada». Importa porque permite tomar unha soa decisión por persoa en lugar dunha por mención, que é onde se producen os esquecementos en documentos longos.
Pódese anonimizar un PDF escaneado sen capa de texto?
Si, mediante recoñecemento óptico, pero con dúas condicións. A primeira é que o proceso corrixa a imaxe antes de transcribila e sexa insensible á falta de tiles. A segunda é que a substitución se aplique sobre os píxeles e non como unha capa superposta, que se retira con calquera visor de PDF.
Que é a k-anonimidade e cando hai que comprobala?
É a garantía de que calquera combinación de atributos dunha táboa se repite polo menos en k persoas, de modo que ningunha queda soa no seu grupo. Convén comprobala sempre que vaias ceder un conxunto de datos con fins estatísticos ou publicalo como datos abertos.
En resumo
Un motor de anonimización solvente non é un buscador de patróns con mellor puntería. É unha cadea de decisións onde cada paso cobre o punto cego do anterior, calibrada sabendo que deixar pasar un dato custa moito máis que riscar un de máis, e capaz de explicar por que fixo o que fixo.
Se queres o detalle do que detecta anonimiza.do, en que formatos e con que garantías, está nas especificacións técnicas. E se prefires velo funcionando, próbao cos teus propios documentos.
Anonimiza os teus documentos sen perder horas
Proba anonimiza.do gratis — 3 documentos ao mes sen tarxeta. Elimina datos persoais de contratos, nóminas e informes en segundos, con plena conformidade co RXPD.
Próbao gratis!